Prompt AI Veo 3 实战指南:快速撰写 AI 视频提示词与提升生成效果
玩转 Veo 3 提示词的最佳方式,绝不是盲目堆砌华丽的辞藻。最核心的策略是建立一套“场景优先(scene-first)”的提示词系统。你需要从一个清晰的镜头、一个主体、一个动作和一个声音层开始。只有在核心创意稳定之后,再去叠加运镜、光影和风格。相比于把一长串杂乱的想法直接塞进 Veo 3 进行单次生成,这种方法能为你节省算力点数、减少随机产出,并带来更干净的画面结果。
大多数用户搜索 Veo 3 提示词,是因为他们想快速得到可用的输出结果。他们不需要又一篇关于“AI 创造力”的抽象空洞指南,而是需要一套能直接用于广告、UGC 短片和电影感镜头的可复用工作流。Google 的官方资料也印证了这一点:细节越多,控制力越强;而且目前的 Gemini 视频生成,在提示词请求简短、视觉化且基于单一镜头时,效果依然是最好的。
1. 在叠加风格词之前,先搭建好 Veo 3 提示词结构
1.1 从“场景优先”的提示词公式开始
提升 Veo 3 提示词效果最快的方法,就是改变你的思考顺序。首先,确定观众在第一秒会看到什么。然后,定义到最后一秒时画面会发生什么变化。之后,按照主体、动作、环境、运镜、光影和声音的顺序来撰写提示词。这能把一段模糊的“文生视频”提示词变成一个生成式视频模型真正可以遵循的镜头计划。
对大多数创作者来说,Veo 3 提示词失败的原因在于:你的想法太宏大,而片段却很短。Gemini 视频生成依然适用于短片生态。采用“8 秒思维”才是王道。当你只要求表达一种情绪、一条运动轨迹和一个视觉目标时,视频合成引擎就更不容易偏离轨道,避免出现随机乱入的物体、糟糕的节奏或平淡的构图。
| 提示词元素 | 糟糕的输入 | 优秀的输入 |
|---|---|---|
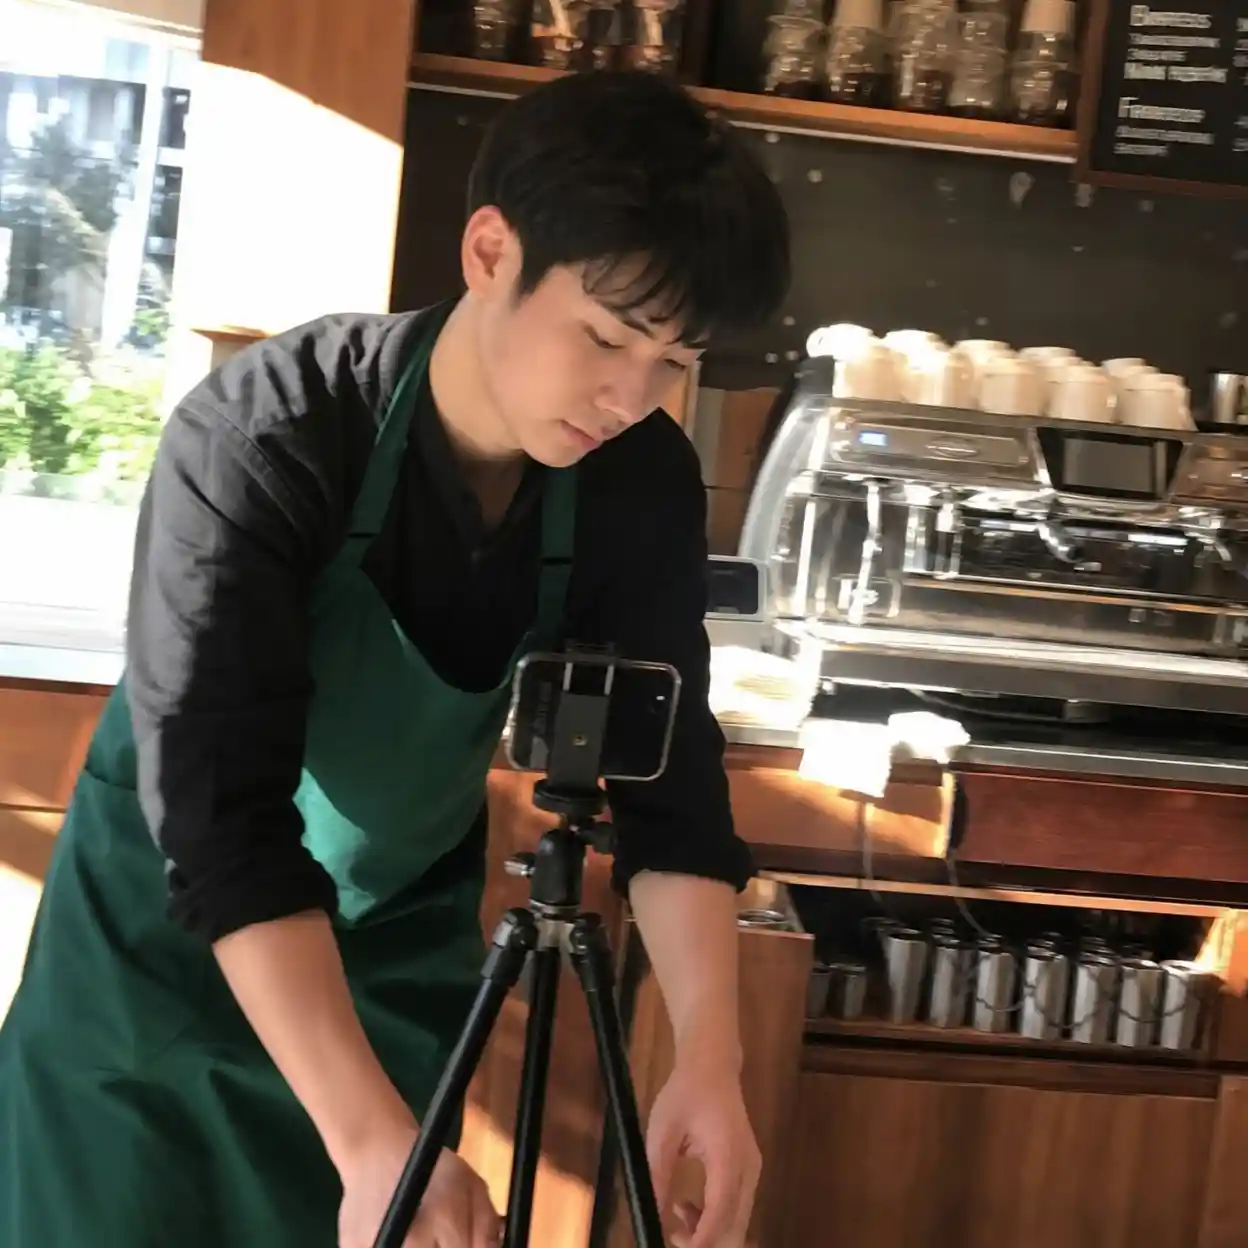
| 主体 | 人 | 穿着绿围裙、留着黑色短发的年轻咖啡师 |
| 动作 | 走路 | 把杯子放在吧台上,并把它推向镜头 |
| 场景 | 咖啡馆 | 阳光明媚的木桌小咖啡馆,咖啡机后冒着蒸汽 |
| 声音 | 好听的音频 | 咖啡研磨机的低鸣、放杯子的轻声、安静的室内环境音 |
| Veo 3 生成结果 | ❌ 随机失控 | ✅ 精准受控 |
这篇 Reddit 指南解释了为什么在跨镜头视频制作中,重复相同的角色描述可以提升人物的一致性
角色一致性指南r/VEO31.2 采用“六层法”,拒绝大段文字堆砌
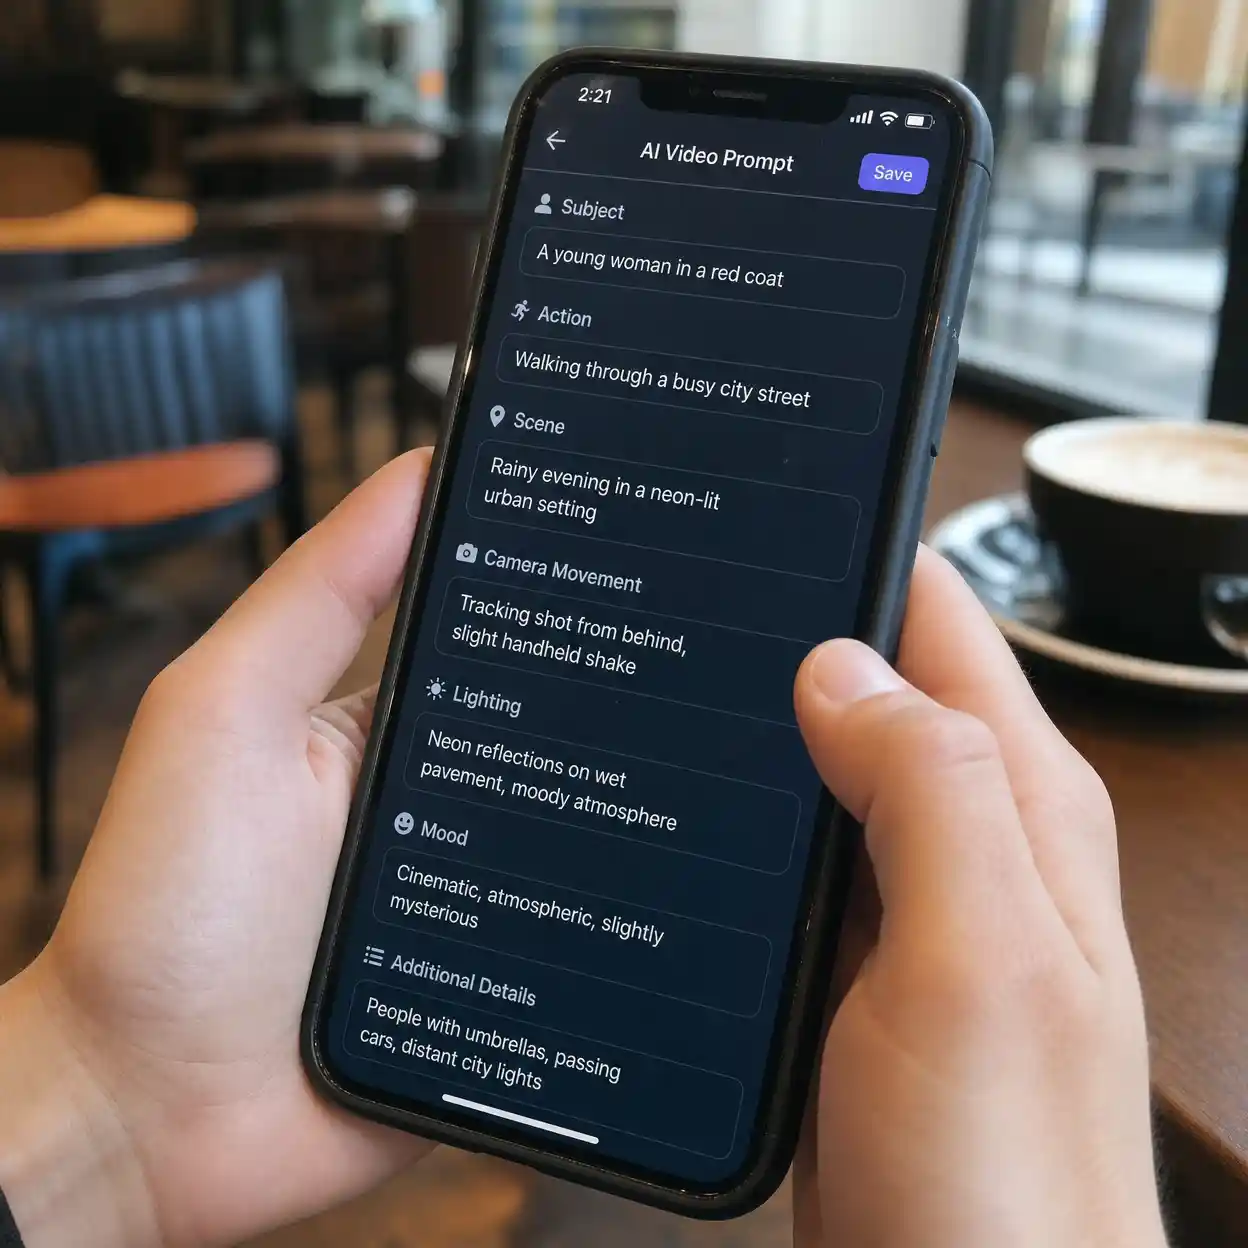
实用的 Veo 3 提示词应该读起来像导演的制作笔记,而不是像写诗。第一层是主体。第二层是具体的动作。第三层是场景。第四层是镜头运动。第五层是光影和色调。第六层是声音。这是非常朴素的创造性提示词工程,但它完美契合了视频合成引擎处理视觉决策的底层逻辑。
Google DeepMind 关于 Veo 提示词的指南也强调了这种方法。它着重于构图与运动、风格、光影、角色描述以及声音。这很关键,因为当每一层都在解决一个独立的视觉决策时,你的 Veo 3 提示词就会变得更强大。你不是在试图让模型变得更聪明,你是在把生成任务拆解得更简单。
1.3 把每个想法拆解为 8 秒的单元
许多用户试图用一次 Veo 3 生成请求来讲述一个长篇故事。这通常会翻车。更好的规划是把脚本拆分成能够独立成立的“镜头单元”。每个镜头应该只包含一个视觉信息、一个动作节拍和一个声音指示。PJ Accetturo 在制作广告风格的 Veo 工作流时也展示了同样的模式:先写脚本,再列镜头清单,最后再生成。
1.4 保持极低的主体数量
Veo 3 提示词另一个常见的失败点是“场景密度过高”。新用户往往在一个镜头里要求出现三个人物、动态背景、各种道具、文字叠加、戏剧性的运镜和复杂的对话。结果往往是初看惊艳,但稍微重播一下就破绽百出。高分辨率的视频生成目标,只有在构图保持清晰可读时才能真正实现。
从一个人或一个核心物体开始。加上一个动作。加上一个声音提示。然后再测试。这就是 Veo 3 提示词从“碰运气”变成一个可控系统的方法。
2. 利用运镜、声音和节奏,让 Veo 3 视频更具“大片感”
2.1 镜头语言对画质的提升远超形容词
大多数人以为 Veo 3 的画面质感来自于各种风格词。而在实际操作中,镜头术语通常更重要。特写(Close-up)、俯拍(overhead)、缓慢推轨(slow dolly)、手持自拍(handheld selfie)、固定三脚架(locked tripod)和侧向跟拍(side tracking),都能促使模型做出更清晰的画面决策。这就是为什么一条带有精确运动指令的朴素提示词,往往能击败一段没有镜头方向的长篇大论。
优秀的 Veo 3 提示词写作也应尊重视频的节奏规律。把主要动作放在中间的两到三秒。用第一秒来建立构图。用最后一秒来完成动作或情绪落点。听起来很基础,但它契合了 AI 短视频在社交平台上的真实消费习惯。
PJ Accetturo 的这期 YouTube 拆解视频展示了“脚本先行”的镜头规划如何将广告创意转化为更易生成和剪辑的短场景
2.2 声音指示是许多 Veo 3 用户容易白费力气的地方
Veo 之所以备受瞩目,是因为“音画同步”成为了创作闭环的一部分。这彻底改变了你写文生视频提示词的方式。如果你不指定音频,系统可能会用一些平庸、嘈杂或喧宾夺主的声音来填补空白。一个干净的 Google Veo 3 提示词工作流,应该明确环境音、是否有说话声,以及是否不需要背景音乐。
Kaycee Hill 在 Gemini 中测试了 Veo 提示词,发现接地气的提示词比堆砌元素的表现更好。当场景有清晰的主体和可信的动作时,她的生成结果最佳。而她失败的案例暴露了 Veo 3 的一个通病:光有怪异的脑洞构不成清晰的结构。如果音频和动作逻辑不清晰,生成的视频依然会搞砸。
2.3 尽早选对画幅比例
如果在生成前就做好画幅决策,Veo 3 的效率会高得多。竖屏社交内容需要更强的中心构图和更简单的背景动作。横屏内容则可以承载更广阔的环境细节。如果你等到生成之后才决定去裁剪,往往会把重要的主体动作给裁掉。
当前的 Gemini 帮助材料也强调了影响 Veo 3 提示词规划的实际限制和控制功能。视频生成可能需要几分钟,画幅比例可以在生成前选择,上传参考图可以引导输出。这些细节至关重要,因为当输入格式与最终用途相匹配时,视频合成引擎的表现会更出色。
2.4 用一个“锚点细节”来增强真实感
一个微小的感官细节,往往比加五个风格标签更能提升 Veo 3 的效果。比如咖啡机旁袅袅升起的蒸汽,湿润人行道上的霓虹灯倒影,或是气泡冒出前拉开易拉罐拉环的“咔哒”声。Lance Ulanoff 在测试 Veo 时踩了另一个常见的坑:过早点击生成而浪费了次数。在工具之外先把提示词打草稿能有效避免这个错误。
3. 直接抄作业:适用于广告、UGC 和电影级短片的 Veo 3 提示词模板
3.1 产品广告模板
强有力的 Veo 3 产品广告应从一个“产品高光时刻”开始。展示物品进入画面、被使用,或者解决了一个肉眼可见的痛点。保持背景干净。使用一种运镜和一个声音记忆点。这种风格的提示词非常适合 SaaS 演示预告、实体产品展示或品牌氛围短片。
可以尝试如下简单的结构:纯净表面上的核心产品,手部互动,缓慢推镜头,柔和的侧光,一个令人愉悦的声音事件,无文字叠加,无人群背景,无多余道具。这不是什么华丽的文章,但它是专为快速迭代打造的高效提示词工程。
这个教程展示了创作者如何使用现成的短视频格式(如 ASMR、自拍视频和电影感开场)来加速测试
3.2 UGC 与自拍模板
UGC 需要一种不同的提示词节奏。镜头应该让人感觉私密、贴近,而不是过度精美。使用手持晃动感、自然的停顿和微小的肢体语言。说明说话者在哪里、拿着什么,以及存在哪些背景噪音。UGC 的提示词工作流还应说明人物是对着镜头说话,还是保持沉默。
这正是现实中的创作者经常“过度打磨”提示词的地方。他们加上了商业级的布光、戏剧性的推轨镜头以及太多的场景过渡。结果视频就不像 UGC 了。对于社交背书(Social proof)类内容来说,只要场景干净且有意图,较低的光鲜度反而是一种优势。
3.3 电影氛围模板
电影感的 Veo 3 提示词需要“克制”。选择一种氛围、一种画幅比例和一条运动轨迹。谨慎使用光影和天气。只要动作保持简单,一个雨巷、日落的尘埃,或是冷蓝色的办公室灯光,就能撑起整个片段。电影级提示词不需要 20 个视觉标签。它只需要一个清晰的构图、一个情绪节拍,以及一个值得剪进序列的绝美结尾画面。
3.4 模板选择对比表
当你觉得 Veo 3 提示词卡壳,不知道先测试哪种风格时,请使用下表。
| 目标 | 最佳模板 | 为什么有效 |
|---|---|---|
| 快速产品演示 | 产品广告 | ✅ 单一核心动作保持画面纯净 |
| 社交背书(带货/安利) | UGC 自拍 | ✅ 自然的运镜让人感觉原生真实 |
| 品牌调性/氛围 | 电影氛围 | ✅ 强光影和声音能营造深度感 |
| 一镜到底讲复杂故事 | 尽量避免 | ❌ Veo 3 极易偏离轨道和崩坏 |
4. 在烧掉更多算力前,修复 Veo 3 常见的翻车问题
4.1 角色不一致
“角色偏移”是 Veo 3 让用户失望的最大原因之一。脸变了、衣服变了、头发变了,有时连年龄段都变了。最好的解决方法虽然无聊但极其有效:每次都重复完全相同的描述词,保持服装简单,在基础形象稳定之前不要添加额外的角色。
如果你有参考图,就用参考图。如果没有,就先建立一个稳定的基础场景。一个一致性强的提示词通常胜过一个自作聪明的提示词。你的源形象越稳定,把多个镜头串联成一个可信的序列就越容易。
这篇 Reddit 帖子解释了为什么 JSON 风格的结构、反向控制(负面提示词)和重复的主体字段可以减少复杂场景中的随机性
JSON 提示词指南r/VEO34.2 光影平淡与画面空洞
很多失败的 Veo 3 短片并没有崩坏,它们只是视觉上很空洞。主体在技术上是正确的,但光线平淡,动作缺乏焦点。解决方法是:明确指定光线方向、一天中的时间,以及一种纹理源(如蒸汽、玻璃反光、雾气、灰尘、雨水或屏幕光晕)。
这也是高分辨率视频生成容易欺骗新手的地方。更高的分辨率并不能带来更好的构图。一个极其清晰的烂镜头,依然是一个烂镜头。然而,一个清晰的好镜头,对于广告、落地页和原生短视频来说,实用价值将成倍增加。
4.3 虚假或刺耳的音频
Veo 3 的音频需要设定边界。如果你只想要室内环境音,请明确写出来。如果不想要人声,也请写明。如果你想要清脆的产品声音,请写出具体的动作事件。在这里,声音不是点缀,它是场景指令不可或缺的一部分。
从创作者测试 Veo 的经验中得出的最实用的教训之一是:当声音被写成一种“制作选择”而不是一个“氛围形容词”时,效果会好得多。清脆的敲击声、柔软的织物摩擦声、远处的交通声、键盘的敲击声和低沉的空调嗡嗡声,都比写一句“沉浸式音频”然后祈祷模型显灵要有用得多。
4.4 快速诊断对比表
当生成结果翻车时,在重写整个想法之前先参考此表。
| 问题 | 可能的原因 | 更好的做法 |
|---|---|---|
| 面部发生变化 | 身份描述信息较弱 | ✅ 在每段提示词中重复同一个角色描述模块 |
| 镜头感觉混乱随机 | 请求塞得太多 | ✅ 删减至只保留一个动作和一个主体 |
| 声音嘈杂杂乱 | 没有设定音频边界 | ✅ 定义精准的声音事件 |
| 画面呆板平淡 | 光影描述含糊 | ✅ 添加光线方向和纹理源 |
| 结果依然很差 | 概念密度太高 | ❌ 不要再堆砌更多形容词了 |
5. 将 Veo 3 生成的片段转化为可发布的视频资产
5.1 多生成几个版本,优中选优
相比于盲目相信第一次生成的片段,对比多个版本能让 Veo 3 发挥出更好的效果。生成两到三个变体。从面部匹配度、动作清晰度、声音干净程度以及结尾画面的质量来评判它们。这个过程感觉较慢,但通常比无休止地随机重写提示词要节省得多。
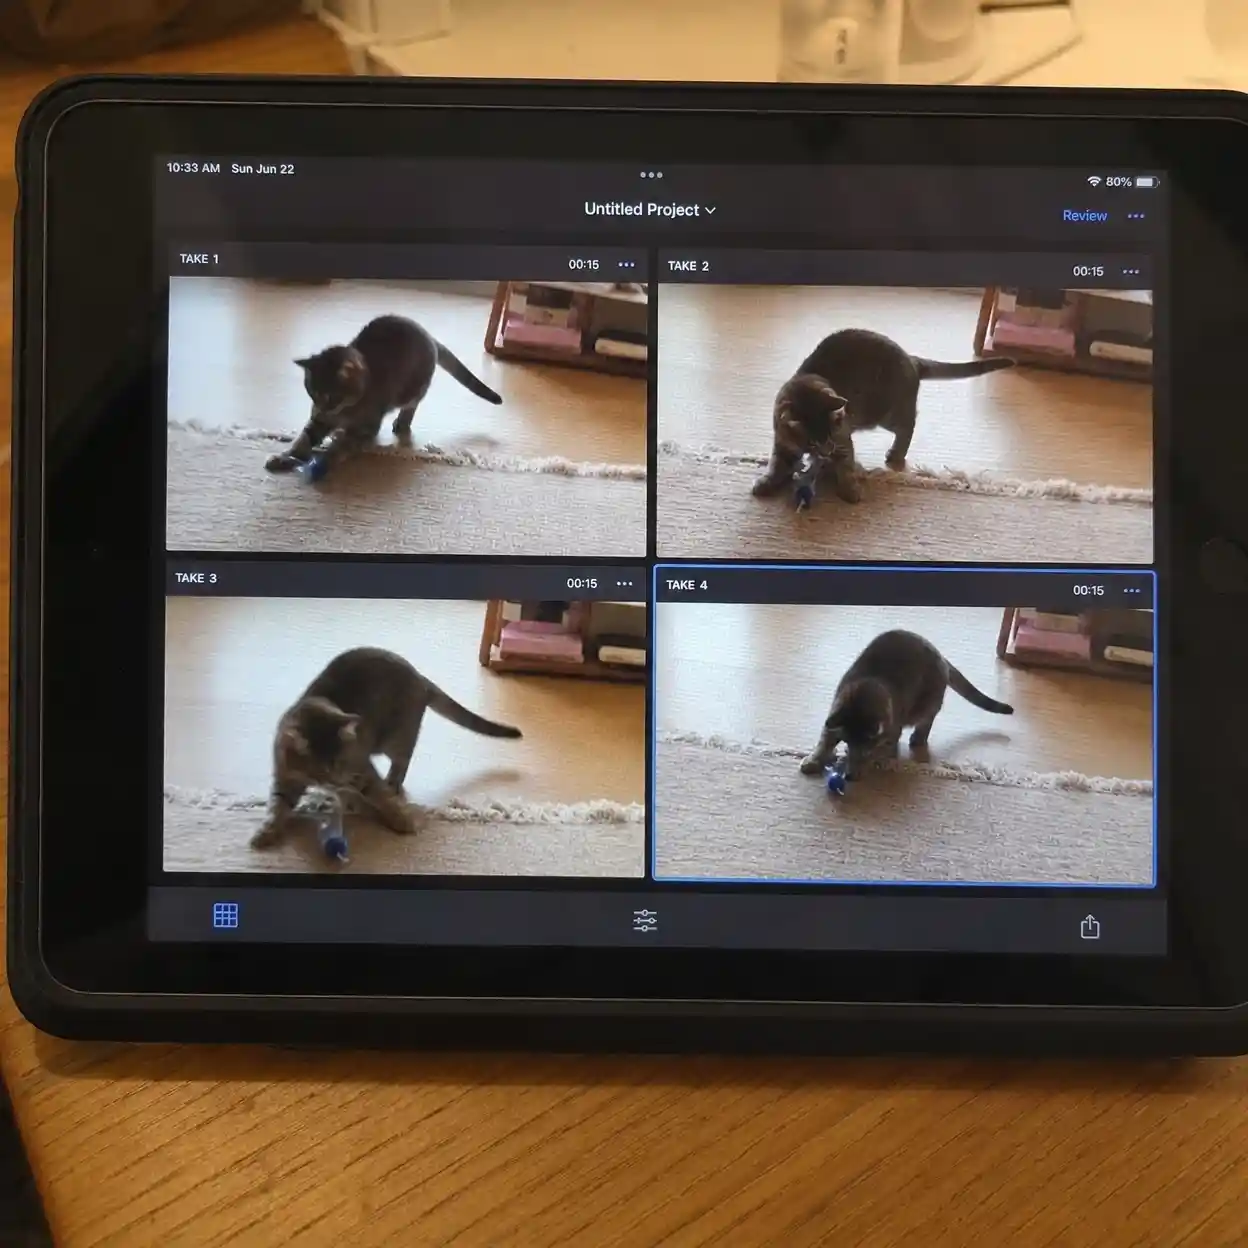
5.2 用短片段构建视频序列
使用 Veo 3 时最大的工作流转变,就是你要接受“一部完整的视频通常是由一段序列拼接而成的”。一个片段用来做开场(Hook)。一个用来展示证据。一个用来表现反应。最后一个用来收尾。Anna Bortsova 曾讨论过用“元提示词(meta prompting)”在生成前细化视频请求,这个理念在这里非常适用。用你的初稿定义意图,然后把这个逻辑转化成每个片段干净利落的 Veo 3 提示词。
5.3 终极工作流总结表
这是适合大多数团队的最简单、可重复的 Veo 3 提示词工作流。
| 步骤 | 动作 | 预期结果 |
|---|---|---|
| 1 | 写下一句核心的场景目标 | ✅ 保持视频片段焦点明确 |
| 2 | 构建一个“六层法”提示词 | ✅ 首发输出质量更高 |
| 3 | 生成 2 到 3 个变体版本 | ✅ 选择空间更大,质量更优 |
| 4 | 每次只修改并修复一个问题 | ✅ 减少算力的无谓浪费 |
| 5 | 在剪辑软件中缝合短片段 | ✅ 得到可规模化发布的最终成片 |
6. 把 Veo 3 提示词当成一个系统,而不是赌博
一旦你不再把 Veo 3 当成盲盒魔法,它就会变得容易驾驭得多。致胜模式非常简单:脚本先行,拆解成短场景,定义运镜和声音,进行小规模测试,然后每次只修改一个变量。这就是引言中提到的“场景优先”系统,它依然是制作产品广告、UGC 和电影级镜头的最可靠路径。
如果你这周想获得更好的效果,不要再去搜罗奇言妙语了。写三个更紧凑的场景提示词,对比看看哪个片段能给你提供最干净、可发布的成果。这种方法能把 Veo 3 提示词变成一个你可以规模化扩展、衡量并不断改进的制作工作流。
参考资料
该博客提供了一个极具竞争力的提示词模板库,涵盖产品、UGC 和电影级应用场景,有助于基准化当前的搜索意图:https://www.media.io/ai-prompts/veo3-prompts.html 这篇论文提出了一种时空扩散设计,以实现更连贯的动作表现,这有助于解释为什么在现代视频生成中,场景的极简性依然至关重要:https://arxiv.org/abs/2401.12945